技术基础
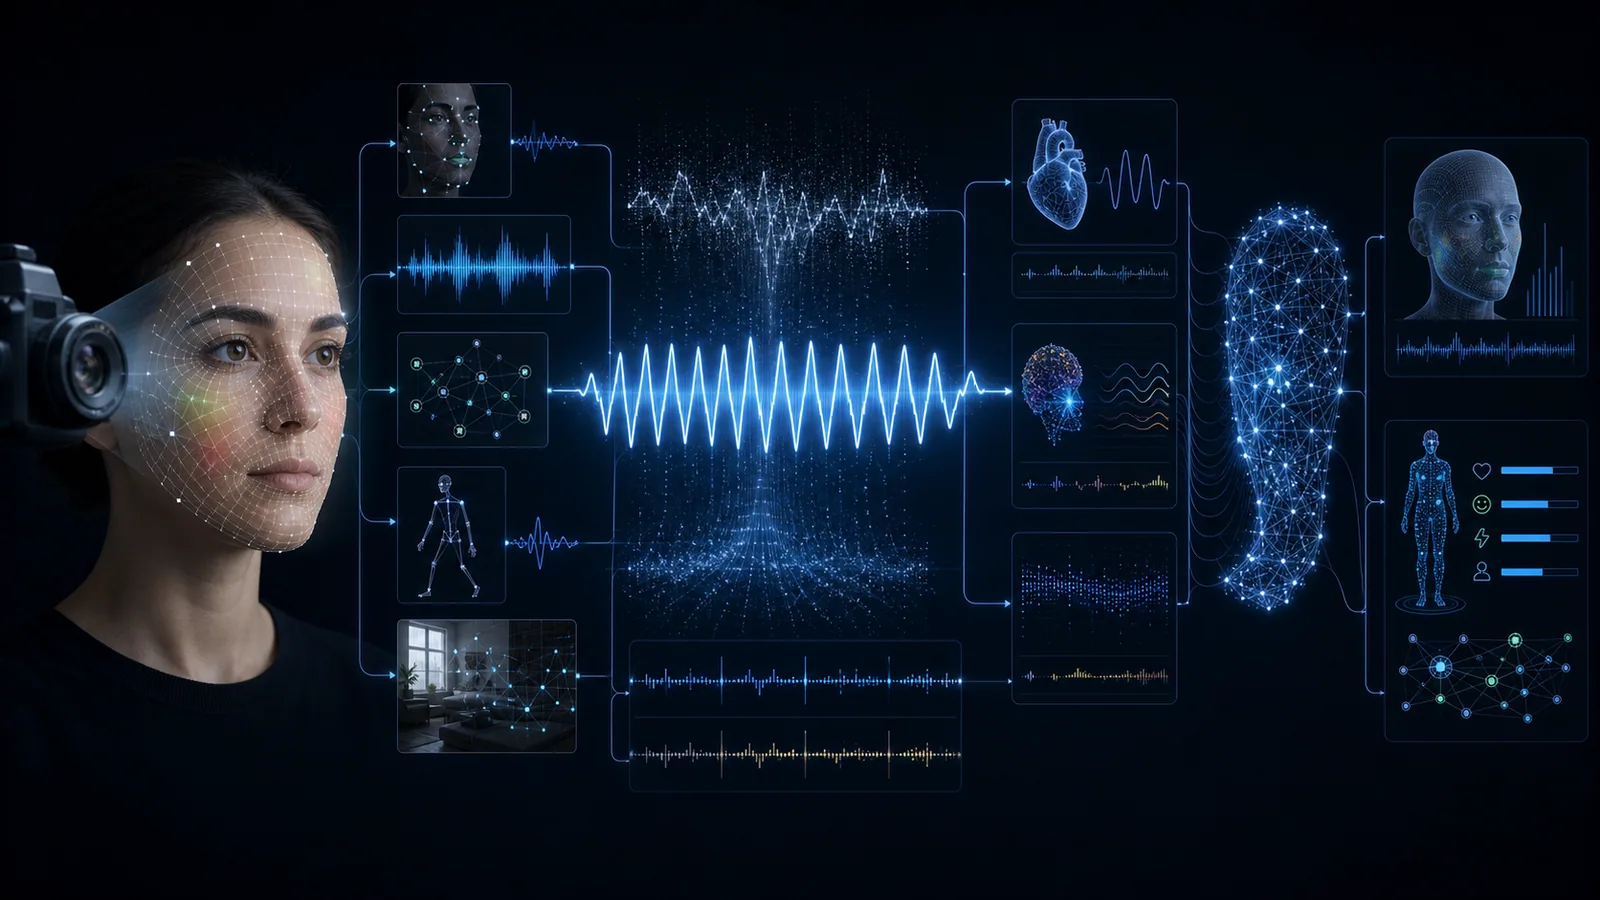
感知与解读基础
- rPPG 生理感知
- 多模态情绪识别
- 语音与语义
- 表情与动作
- 姿态与场景理解
- 科思大模型
统一平台
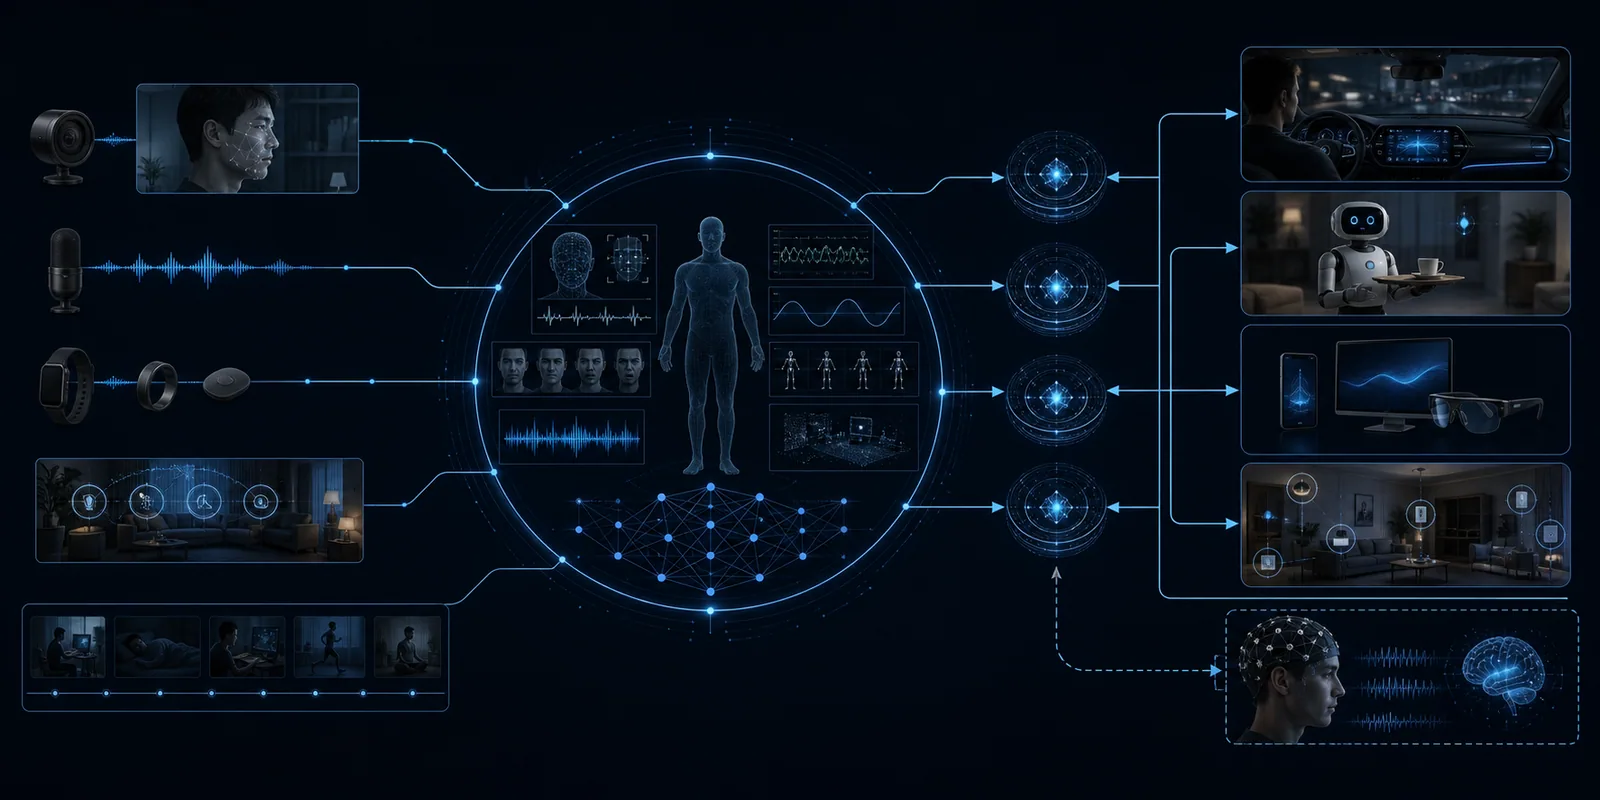
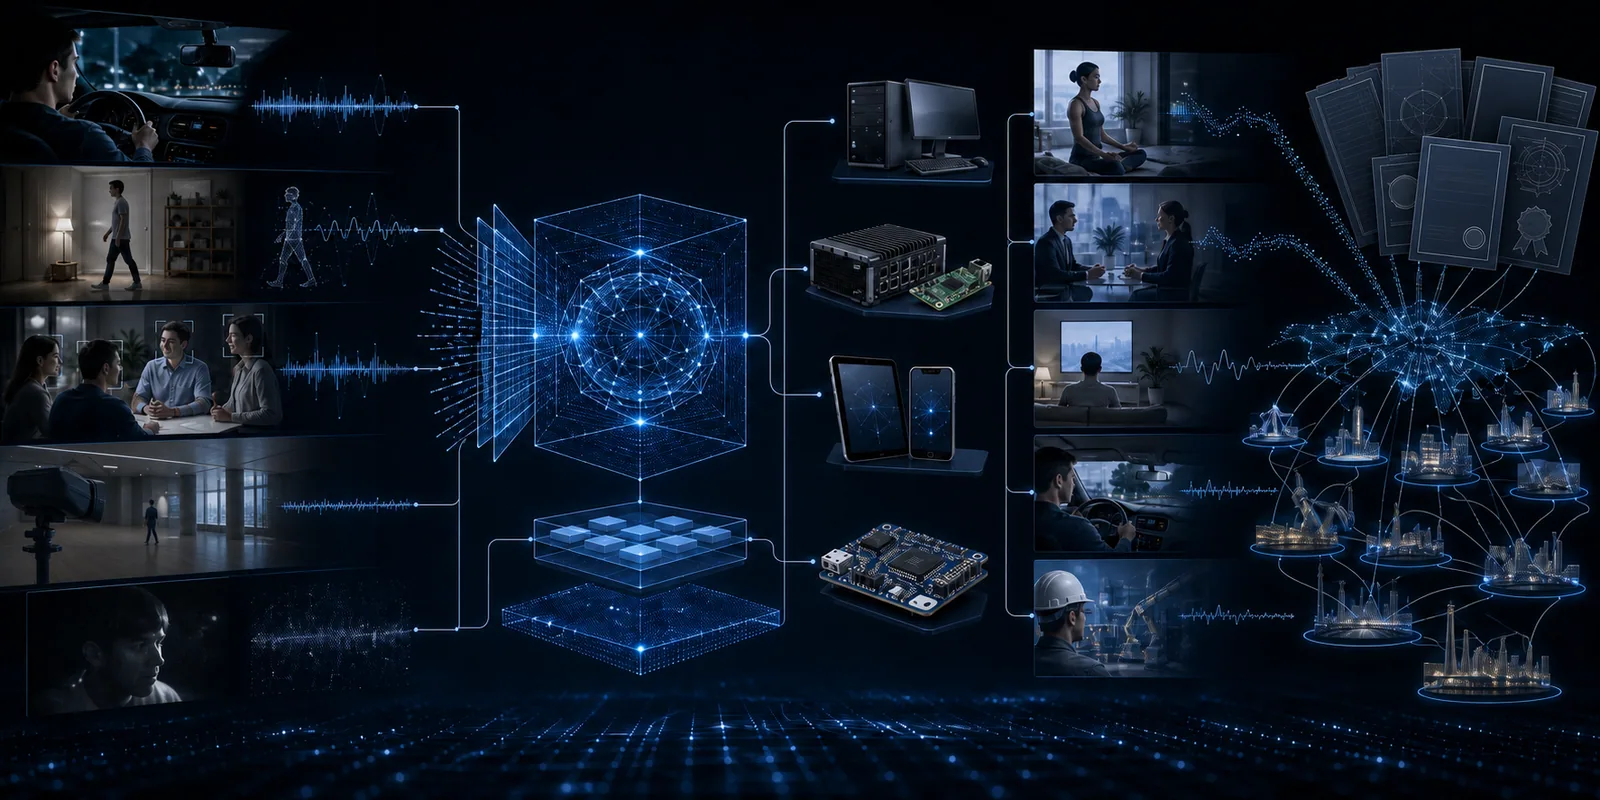
平台统一处理生理、多模态和历史信息,通过人体状态智能引擎 SDK、明眸、明镜与离线边缘计算设备输出,并接入车载座舱、机器人、个人终端、智慧空间和脑机接口等外部系统。
技术基础
核心能力
六项核心能力可按场景组合,形成从感知、分析到状态解读的完整链路。
产品载体
Physical AI
应用场景
质量门控 · 低算力适配 · 芯片与国产操作系统兼容 · 本地离线 · 接口与验证
技术架构
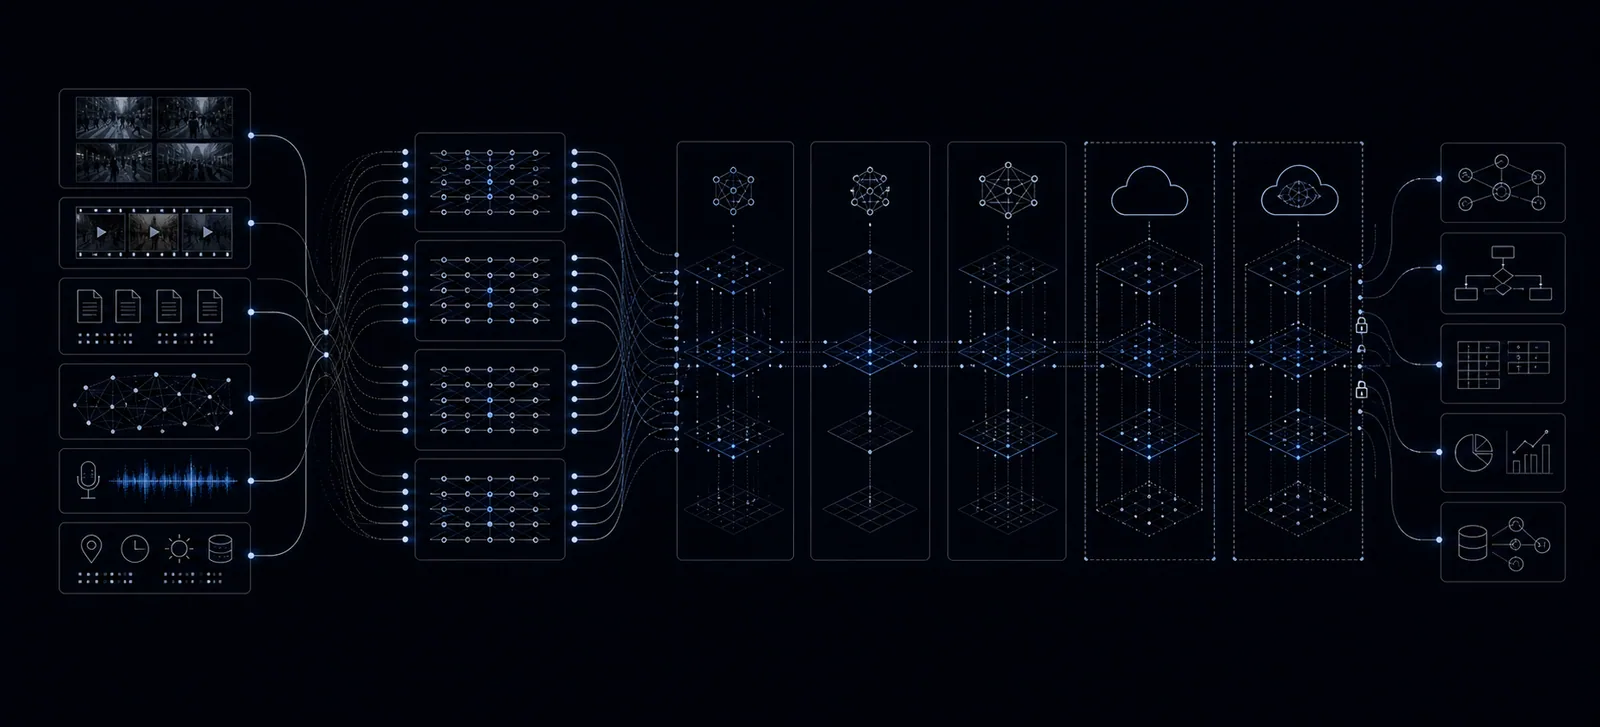
从多源信号进入,到生理感知、多模态融合和状态解读,再形成可接入业务的状态结果与辅助建议。
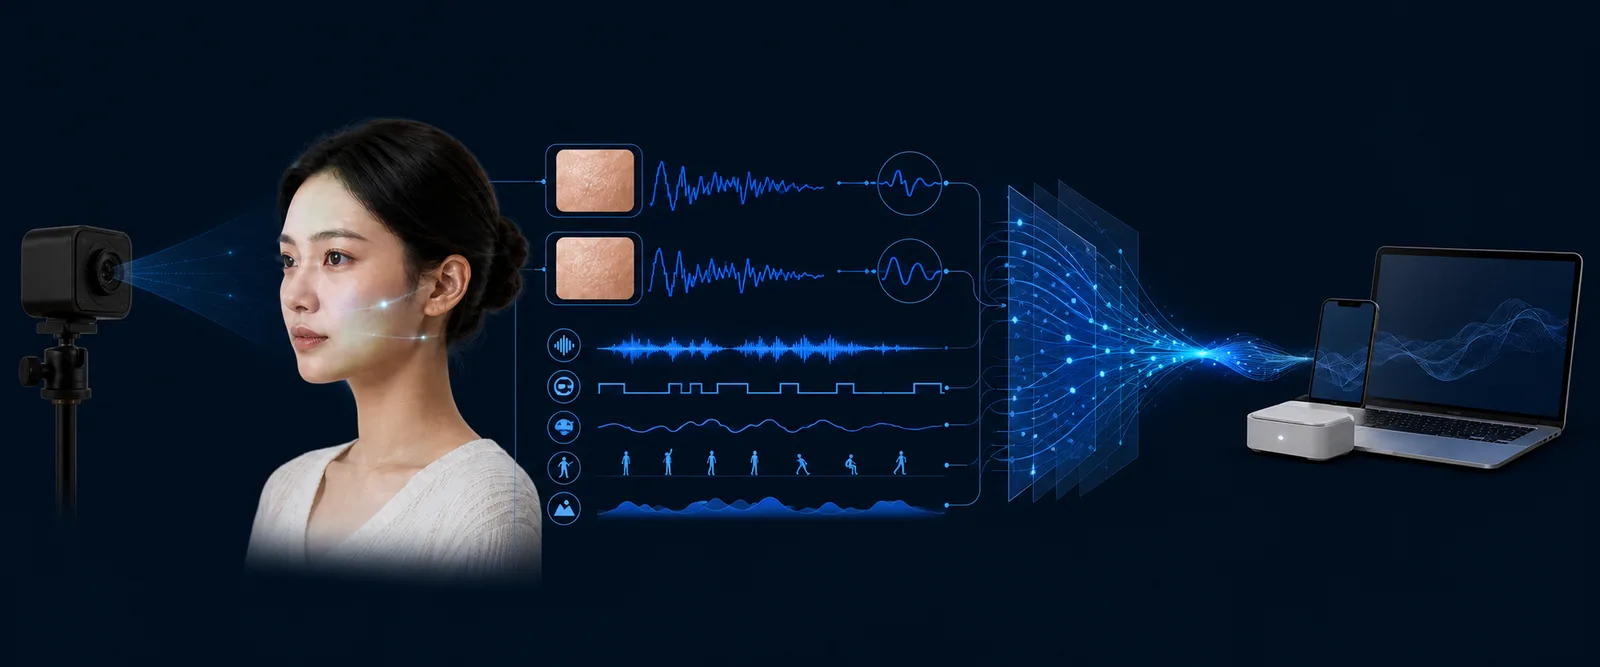
接收普通摄像头画面或视频流,保留与状态判断有关的连续信号和场景信息。
抑制光照变化和运动伪影干扰,恢复稳定、可测的 rPPG 生理信号。
融合生理、表情、语音、语义、姿态与场景信息,提升情绪识别的准确性与稳定性。
形成面向当前状态的生理和情绪指标,并附带输入与结果质量信息。
结合历史与场景上下文组织结果,为业务流程提供辅助建议。
输入质量判断 · 多模态交叉校验 · 结果质量状态 · 现场复测与问题回流
核心优势
rPPG 提供准确、连续的生理指标,多模态输入共同判断情绪和状态,科思大模型结合历史与场景解释变化。
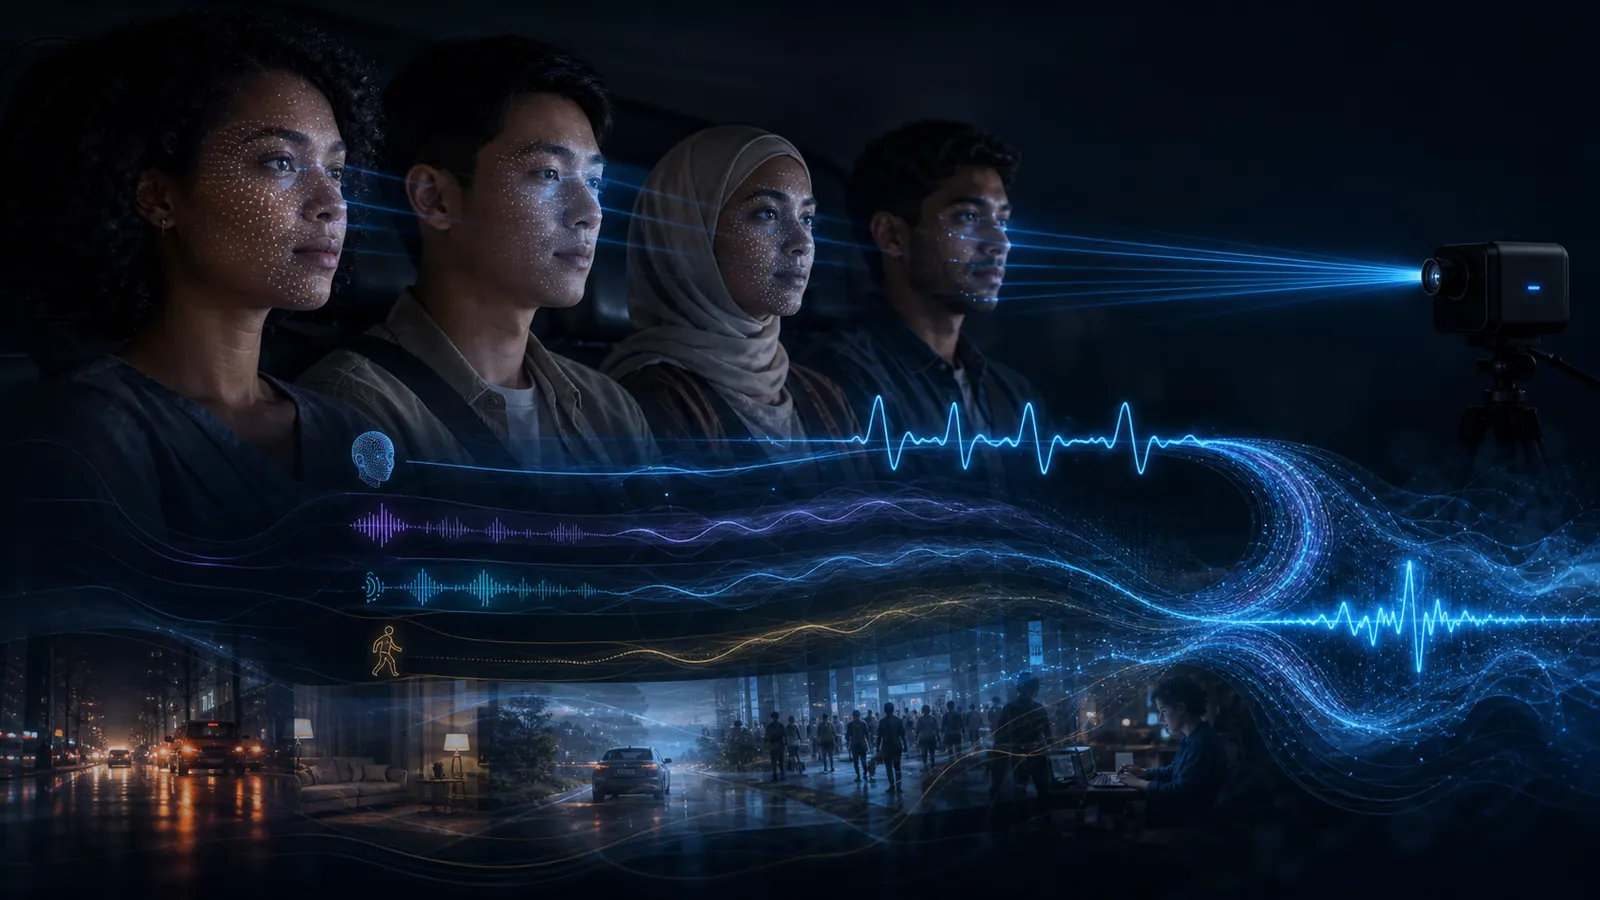
针对光线变化、运动、谈话和车辆振动等干扰,持续提高 rPPG 生理指标的准确性和稳定性。
长期算法迭代覆盖不同摄像头、图像芯片、肤色和现场条件,持续提升算法的适应性与鲁棒性。
在准确生理指标的基础上,融合表情、声音、表达内容和姿态,减少单一线索造成的误判。
科思大模型把当前结果、历史变化和场景上下文放在一起解释,为后续业务动作提供参考。
核心能力
六项能力按场景组合,贯通生理感知、情绪识别、语音语义与状态解读。
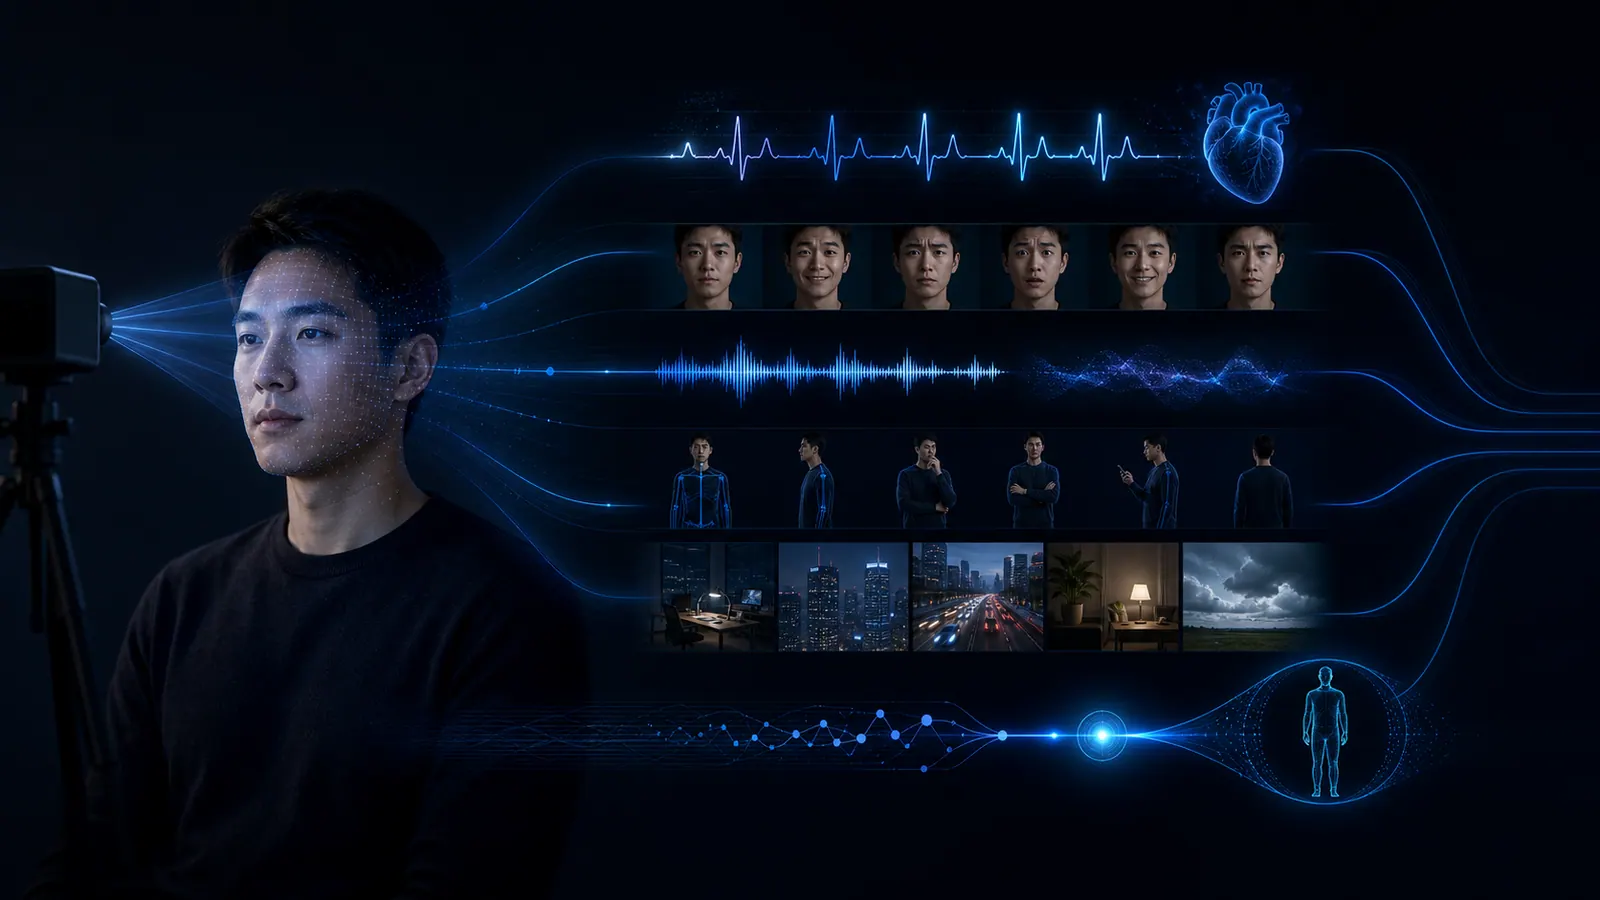
从摄像头或视频输入中恢复微弱 rPPG,形成非接触生理指标和质量状态。
以准确生理指标为主要依据,结合表情、声音、表达内容和现场信息交叉判断。
支持语音转写、说话人识别以及语音和语义情绪分析,可按项目独立部署。
读取面部和身体变化,为生理与情绪结果补充行为线索。
把光线、人员关系、活动和业务环境纳入结果判断。
结合多模态结果、历史信息和场景上下文,输出状态解读与辅助建议。
工程优势
算法覆盖多类芯片、操作系统和低算力端侧平台,并已在多个国家和地区的不同人群与真实环境中持续运行。
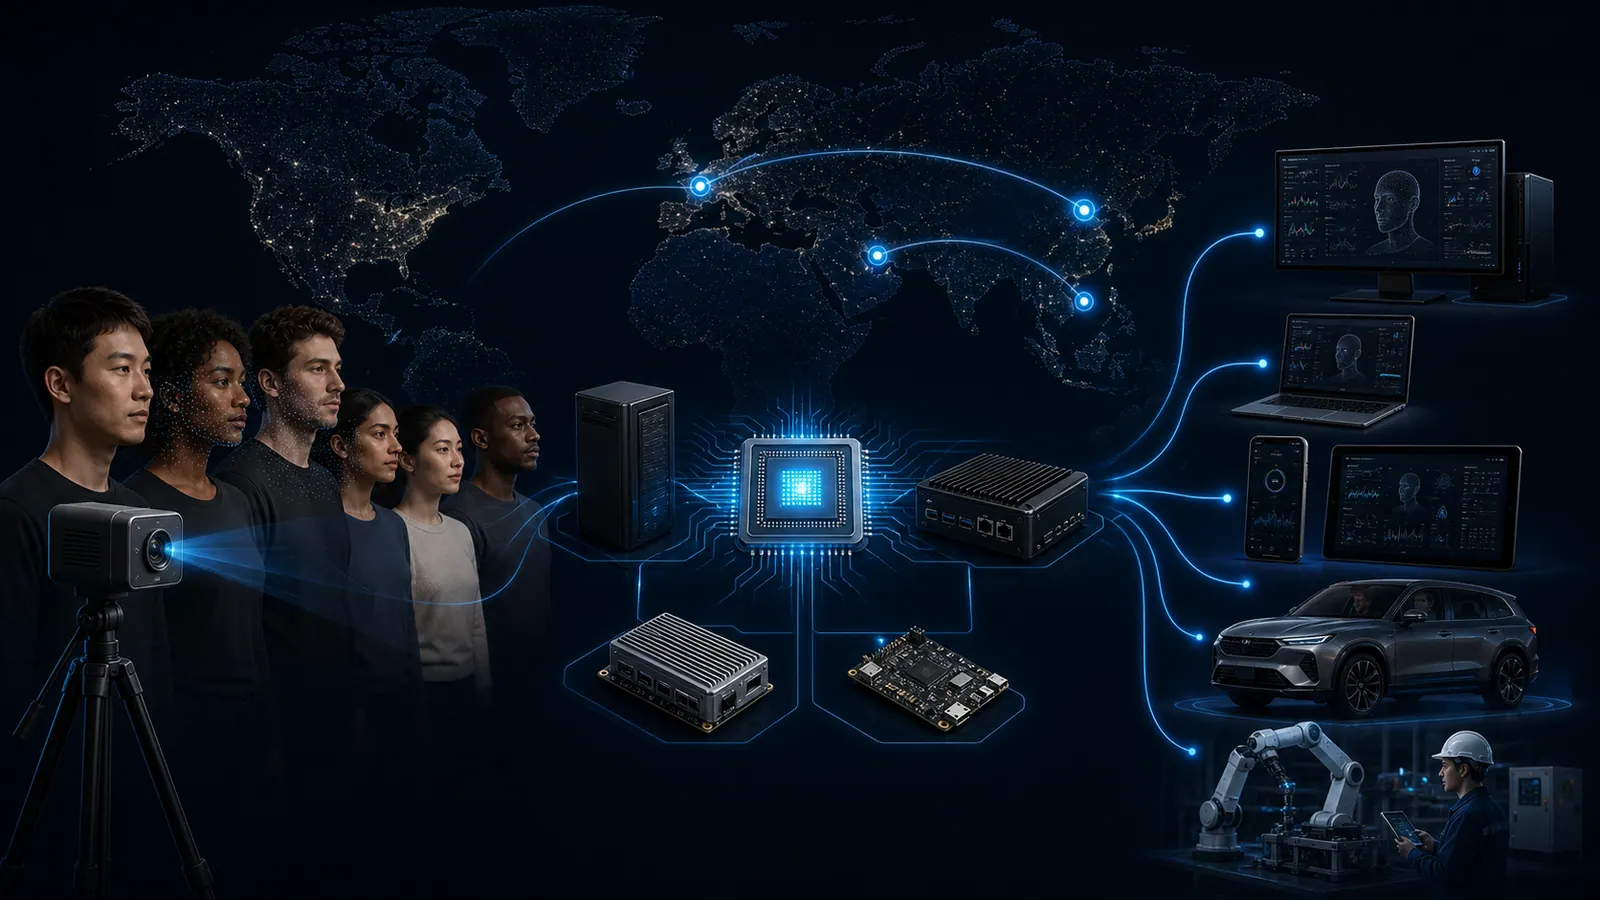
算法经过多个真实场景的长期迭代,已适配多类图像芯片与现场输入环境。
覆盖多款国产 CPU、国产操作系统,以及 x86、ARM、Windows、Android 和 iOS。
可根据算力和输入质量做轻量化与质量门控,适配范围包括 STM32。
接收本地相机采集的 frame、视频流、文件、音频和业务上下文。
产品已在中国、法国、中东、韩国和越南部署,持续面对不同肤色、光照条件与使用环境,验证了算法在多人种场景下的适应性与鲁棒性。
接入与部署
支持摄像头、音视频流和业务上下文接入,可通过人体状态智能引擎 SDK、软硬一体设备和离线边缘计算设备连接业务系统。
验证与落地
IEEE TIM · 2023
IEEE Transactions on Instrumentation and Measurement
仪器与测量领域的国际顶级学术期刊
面向道路驾驶中的光照变化,研究基于近红外成像的非接触式心率监测。
科思创动研究人员与清华大学研究人员共同署名。
IEEE TAI · 2025
IEEE Transactions on Artificial Intelligence
IEEE 人工智能领域的重要国际学术期刊
研究 EEG 与视频特征的层次化融合,为多模态情绪识别提供算法思路。
公司股东徐明为第一作者,论文署名单位为清华大学自动化系。